SGF 기보로 학습하는 바둑 LLM 인공지능
기보 수집, VLM/LLM 미세조정, 인간과의 대국까지 이어지는 바둑 AI 만들기
왜 SGF 기보인가
바둑은 가능한 수가 너무 많다. 19x19 판에는 361개의 교차점이 있고, 돌이 놓일수록 집, 활로, 단수, 패, 사활, 끝내기 같은 의미가 계속 바뀐다. 초기 모델이 무작위 자기대국만으로 좋은 감각을 얻기에는 너무 큰 문제다.
그래서 먼저 사람의 기보를 사용한다. SGF 파일은 바둑 한 판의 수순, 보드 크기, 덤, 승패, 핸디캡 같은 정보를 담는 표준 포맷이다. 이 프로젝트는 SGF를 읽어 '이 국면에서 다음 한 수는 어디인가'라는 학습 예제로 바꾼다.
프로젝트 전체 흐름
SGF 다운로드
  -> SGF 파싱
  -> 국면별 보드 이미지 + 텍스트 격자 생성
  -> JSON 응답 형식의 SFT 데이터셋 생성
  -> Gemma 4 VLM LoRA 학습
  -> GO19 TCP 서버로 추론
  -> Qt 바둑 프로그램에서 인간 또는 AI와 대국
구성요소 | 역할 |
|---|---|
sgf_download.py | 공개 기보 저장소에서 KGS4d SGF 압축 파일을 내려받고 sgf_data에 푼다. |
sgf_parser.py | SGF에서 SZ, KM, HA, AB/AW, B/W, RE 태그와 메인 수순을 읽는다. |
dataset_baduk.py | SGF 수순을 보드 이미지와 JSON 정답이 있는 SFT 예제로 바꾼다. |
train_lora.py | Gemma 4 VLM에 LoRA 미세조정을 수행한다. |
server.py | 학습된 모델을 GO19 TCP 서버로 띄워 다음 수를 예측한다. |
baduk Qt 앱 | 인간 대 VLM, AI 대 VLM, VLM 대 VLM 대국을 제공한다. |
1단계: SGF 파일 수집
프로젝트의 실제 구현은 u-go.net의 KGS4d 공개 기보 다운로드 파이프라인을 사용한다. 책에서는 이를 '기보 제공처에서 SGF 파일을 받는 단계'로 설명하면 좋다. 사용자가 말한 한국기원 기보도 SGF로 확보할 수 있다면 이후 과정은 같다.
python -m vlm_server.sgf_download --years 2018 --out-dir sgf_data
python -m vlm_server.sgf_download --months 2018-06 2018-07 --out-dir sgf_data
python -m vlm_server.sgf_download --years 2018 --list-only
현재 작업 폴더의 sgf_data에는 159,772개의 SGF 파일이 들어 있다. 이 정도 규모면 단순한 오프닝 감각뿐 아니라 중반 전투와 끝내기 국면도 상당히 많이 포함된다.
2단계: SGF를 읽어 국면으로 복원하기
sgf_parser.py는 학습에 필요한 최소한의 SGF 속성을 읽는다. 바둑판 크기, 덤, 핸디캡, 사전 배치 돌, 흑백 수순, 승패 결과가 핵심이다.
SGF 태그 | 의미 |
|---|---|
SZ | 보드 크기. 이 프로젝트의 학습은 주로 19x19를 사용한다. |
KM | 덤. 백에게 더해지는 점수다. |
HA | 핸디캡 정보다. |
AB/AW | 초기 배치된 흑돌/백돌이다. |
B/W | 흑 또는 백의 한 수다. 빈 값이나 tt는 패스로 본다. |
RE | 결과. B+R, W+12.5 같은 값에서 승자를 추출한다. |
파서는 변형 수순 전체를 깊게 다루기보다 첫 메인 라인에 집중한다. 책의 실습 목적은 완전한 SGF 편집기가 아니라, 대량의 기보에서 다음 수 예제를 안정적으로 만드는 것이다.
3단계: 바둑 규칙으로 합법성 검증하기
SGF 수순을 그대로 텍스트로만 학습하면, 모델은 좌표 형식은 배워도 바둑 규칙을 충분히 체화하지 못할 수 있다. dataset_baduk.py 안에는 작은 Go 시뮬레이터가 들어 있어 착수, 따냄, 활로, 자살수 여부를 검사한다.
Qt 앱 쪽의 GoBoard도 실제 대국 규칙을 담당한다. 따냄, 자살수 금지, 위치 슈퍼코, 패스, 기권, 중국식 면적 계가, 덤 처리를 구현한다. 즉 학습 데이터 생성기와 실제 대국 프로그램 모두에서 규칙 검증이 들어간다.
규칙 | 프로그램에서의 처리 |
|---|---|
따냄 | 상대 그룹의 활로가 0이 되면 해당 돌을 제거한다. |
자살수 금지 | 착수 후 자기 그룹 활로가 0이면 불법수로 본다. |
위치 슈퍼코 | 과거 보드 상태와 같은 상태를 만들면 금지한다. |
패스 | row=255, col=255로 서버와 클라이언트 사이에서 표현한다. |
계가 | 중국식 area scoring. 돌 수와 영역에 덤을 더한다. |
4단계: SFT 데이터셋 만들기
dataset_baduk.py는 각 게임에서 여러 국면을 뽑아 학습 예제로 만든다. 한 예제는 보드 이미지, 텍스트 격자, 다음 수 JSON으로 구성된다. VLM은 이미지를 통해 시각적 바둑판을 보고, 텍스트 격자를 통해 정확한 좌표와 돌 배치를 확인한다.
python -m vlm_server.dataset_baduk \
  --sgf-dir sgf_data \
  --out-dir sft_data/baduk_v2 \
  --max-games 5000 --moves-per-game 24 \
  --winner-only --tactical-bias --dedup \
  --oversample-tactical 3 \
  --val-split 0.05 --shuffle
옵션 | 목적 |
|---|---|
winner-only | 승리한 쪽의 수만 학습해 노이즈를 줄인다. |
tactical-bias | 잡기, 단수, 단수회피, 끊기 같은 전술 순간 비율을 높인다. |
oversample-tactical 3 | 전술 샘플을 세 번씩 반복해 단수 응수와 전투 감각을 강화한다. |
dedup | 같은 보드와 같은 정답 수가 중복되면 제거한다. |
val-split 0.05 | 검증셋을 분리해 학습 중 과적합을 볼 수 있게 한다. |
현재 baduk_v2 데이터셋은 train 226,071개, val 11,747개 예제로 구성되어 있다. 5,000개 SGF 입력 중 4,989개 게임이 사용되었고, 중복 제거로 3,594개 샘플이 빠졌다.
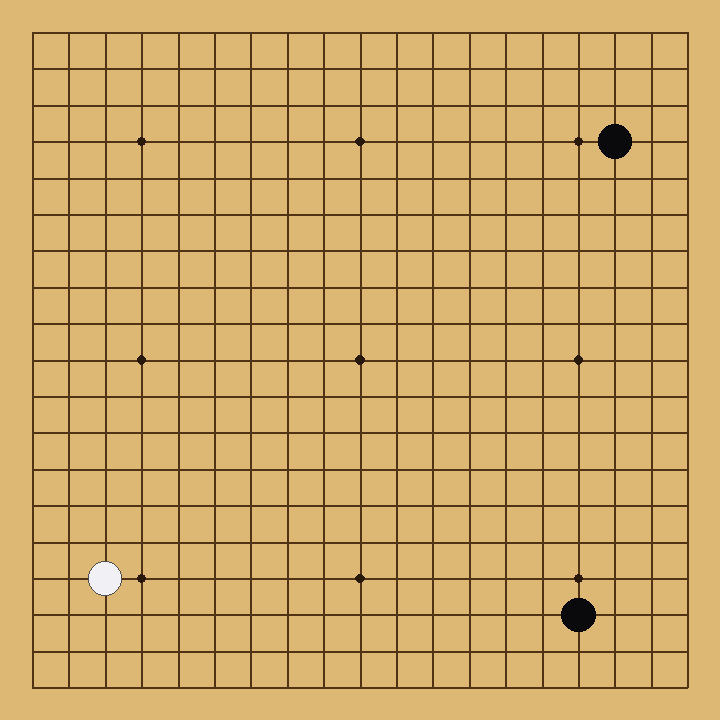
그림. SGF에서 복원한 바둑 학습용 보드 이미지 예시
5단계: 모델이 답해야 하는 형식
학습 예제의 정답은 자유로운 해설이 아니라 한 줄 JSON이다. 바둑 AI가 실제 GUI에서 두려면 결국 row, col 좌표가 필요하기 때문이다.
{"row": 4, "col": 3}
{"pass": true}
이 형식을 강하게 고정하면 서버가 응답을 파싱하고 합법성 검사를 하기 쉬워진다. LLM을 게임 엔진에 붙일 때는 자연어 설명보다 실행 가능한 짧은 구조화 출력이 훨씬 안정적이다.
6단계: LoRA로 바둑 감각 미세조정하기
train_lora.py는 mlx-vlm의 LoRA 학습을 감싸는 스크립트다. 기본 모델은 Apple Silicon에서 돌리기 좋은 Gemma 4 계열 양자화 모델을 사용한다. 전체 모델을 다시 학습하지 않고, 작은 LoRA 어댑터를 학습해 바둑 좌표 선택 능력을 주입한다.
python -m vlm_server.train_lora \
  --dataset-jsonl sft_data/baduk_v2/train.jsonl \
  --val-jsonl     sft_data/baduk_v2/val.jsonl \
  --model mlx-community/gemma-4-e4b-it-4bit \
  --output-dir vlm_models/lora_baduk_v2 \
  --epochs 3 --batch-size 1 --grad-accum 16 --lr 1e-4 \
--lora-rank 16 --lora-alpha 32 --grad-checkpoint7단계: GO19 서버로 인간과 대국하기
학습된 LoRA를 추론 서버에 얹으면 Qt 바둑 프로그램이 사람과 VLM의 대국을 진행할 수 있다. 클라이언트는 매 차례 보드 PNG와 19x19 격자 바이트를 서버로 보낸다. 서버는 모델에게 다음 수를 묻고, 합법 좌표를 RPLY 프레임으로 돌려준다.
HF_HOME=$PWD/vlm_models HF_HUB_CACHE=$PWD/vlm_models \
python -m vlm_server serve --port 9319 \
  --model mlx-community/gemma-4-e4b-it-4bit \
  --lora-dir vlm_models/lora_baduk_v2 \
  --log-jsonl logs/baduk_play.jsonl
대국 모드 | 용도 |
|---|---|
사람 대 VLM | 독자가 직접 학습된 모델과 대국한다. |
AI 대 VLM | 로컬 휴리스틱 AI가 모델의 약점을 빠르게 드러낸다. |
VLM 대 VLM | 같은 모델끼리 self-play하거나 두 LoRA 버전을 비교한다. |
학습 모드 | 종국된 판을 recordings/*.sgf로 저장해 다음 학습에 재사용한다. |
8단계: 인간 대국을 다시 학습 데이터로
Qt 앱의 학습 모드 체크박스를 켜면 종국된 판이 SGF로 저장된다. 사람이 VLM과 둔 기보, AI와 VLM이 둔 기보, VLM끼리 둔 기보를 모두 다음 학습 데이터에 섞을 수 있다.
cp recordings/*.sgf sgf_data/

python -m vlm_server.dataset_baduk \
  --sgf-dir sgf_data \
  --out-dir sft_data/baduk_v3 \
  --max-games 10000 --moves-per-game 24 \
  --winner-only --tactical-bias --dedup \
  --val-split 0.05 --shuffle
이 반복이 이 장의 핵심 학습 루프다. 외부 기보로 기본 감각을 만들고, 인간과의 대국 또는 자기대국에서 나온 SGF를 다시 섞어 모델을 갱신한다.
강화학습과의 관계
이 장의 방법은 순수한 AlphaGo식 강화학습과는 다르다. 여기서는 먼저 SGF 기보 기반의 지도 미세조정으로 정책을 만든다. 그 다음 사람/AI/VLM 대국을 통해 새 데이터를 모으고, 승자 중심 또는 전술 중심으로 다시 학습한다.
접근 | 이 장에서의 의미 |
|---|---|
지도 미세조정 | SGF에서 다음 수를 뽑아 모델이 좌표 JSON을 따라 하게 한다. |
모방 학습 | 승자의 수, 강한 플레이어의 수를 좋은 행동 예시로 본다. |
자기대국 | VLM 대 VLM 또는 AI 대 VLM으로 새 SGF를 만든다. |
적대적 개선 | 상대와 둔 결과를 다시 데이터에 넣어 약점을 줄인다. |
강화학습 확장 | 추후 승률 보상, 정책 평가, MCTS 결합으로 확장할 수 있다. |
실습 순서
- SGF 수집: 기보 제공처에서 SGF를 받거나 sgf_download.py로 공개 KGS4d 기보를 내려받는다.
- SGF 파싱 확인: sgf_parser.py로 수순, 승자, 덤, 패스가 정상적으로 읽히는지 확인한다.
- SFT 데이터셋 생성: dataset_baduk.py로 보드 이미지와 JSON 정답이 있는 train/val 데이터셋을 만든다.
- LoRA 학습: train_lora.py로 Gemma 4 VLM에 바둑 정책을 미세조정한다.
- 서버 실행: 학습된 LoRA를 --lora-dir로 지정해 GO19 서버를 띄운다.
- 인간과 대국: Qt baduk 앱에서 사람 대 VLM 모드를 선택하고 모델과 둔다.
- 기보 재수집: 학습 모드로 저장된 SGF를 다음 라운드 데이터에 섞는다.
주의할 점
- SGF 제공처의 이용 조건을 확인하고, 재배포가 가능한 데이터인지 구분해야 한다.
- 강한 기보만 학습하면 기본 감각은 좋아지지만, 모델 자신의 실수 패턴을 고치려면 실전 대국 기보도 필요하다.
- winner-only는 노이즈를 줄이지만, 패배한 쪽에도 좋은 수가 있을 수 있다는 점을 잊으면 안 된다.
- 전술 샘플을 너무 많이 오버샘플링하면 포석과 전체 형세 감각이 약해질 수 있다.
- 서버는 모델 응답을 그대로 믿지 말고 점유, 자살수, 패, 슈퍼코를 반드시 검증해야 한다.
마무리
이 장의 바둑 AI는 SGF에서 시작한다. 기보는 인간과 강한 플레이어가 남긴 행동의 기록이고, LLM/VLM은 그 기록을 보드 이미지와 텍스트 격자 형태로 학습한다. 그 결과 모델은 현재 국면을 보고 다음 좌표를 JSON으로 답할 수 있게 된다.
중요한 점은 여기서 끝나지 않는다는 것이다. 학습된 모델은 다시 인간과 대국하고, 그 대국은 다시 SGF가 되며, 다시 데이터셋이 된다. 바둑 AI를 만드는 과정은 한 번의 학습이 아니라 기보 수집, 학습, 대국, 재수집을 반복하는 긴 순환이다.
연습 문제
- winner-only 옵션을 끄면 어떤 종류의 데이터 노이즈가 늘어날지 설명해 보자.
- 전술 샘플 oversample 값을 1, 3, 5로 바꿨을 때 모델의 스타일이 어떻게 달라질지 예상해 보자.
- 사람 대 VLM 기보를 학습 데이터에 섞으면 모델이 사용자 스타일을 따라 할 가능성이 있는지 생각해 보자.
- JSON 좌표 대신 자연어 해설까지 함께 학습시키면 실제 대국 서버에서는 어떤 장단점이 생길까?
댓글 0
아직 댓글이 없습니다.