LoRA로 발전하는 가상 피팅 인공지능
사람과 옷 이미지를 받아, 그 사람이 실제로 입은 것처럼 생성하는 개인화 모델 만들기
왜 가상 피팅인가
온라인 쇼핑에서 가장 큰 불안은 '이 옷이 나에게 어울릴까'라는 질문이다. 옷 사진만으로는 길이, 어깨선, 허리 핏, 소재의 흐름을 상상하기 어렵다. 가상 피팅 인공지능은 사람 이미지와 옷 이미지를 함께 보고, 그 사람이 그 옷을 입은 장면을 만들어 이 불안을 줄인다.
하지만 좋은 가상 피팅은 단순 합성이 아니다. 얼굴과 체형은 유지해야 하고, 옷의 디자인은 보존해야 하며, 팔과 몸통의 가려짐도 자연스러워야 한다. 게다가 쇼핑 화면에서는 정면만이 아니라 45도, 측면, 후면 같은 다양한 각도가 필요하다.
프로젝트의 출발점
maLora 프로젝트는 Qwen-Image-Edit-2511 기반 이미지 편집 모델에 Multiple-Angles LoRA를 적용해, 한 장의 사람 이미지를 여러 시점으로 바꾸는 로컬 실험이다. 지금 코드에는 사람 이미지 한 장을 입력하고, '<sks> front-right quarter view eye-level shot medium shot' 같은 프롬프트로 각도와 카메라 거리를 제어하는 구조가 들어 있다.
python infer.py \
  --image inputs/human1.png \
  --prompt "<sks> front-right quarter view eye-level shot medium shot" \
  --output outputs/human1_front_right_quarter_view.png \
  --lora-scale 0.9 \
  --steps 40
파일 | 역할 |
|---|---|
infer.py | 입력 이미지를 받아 Qwen 이미지 편집 모델과 LoRA를 적용해 한 장의 결과 이미지를 생성한다. |
rotate_4angles.py | 0도, 45도, 90도, 135도 시점 이미지를 순서대로 생성한다. |
download_lora.py | Hugging Face의 LoRA safetensors 파일을 로컬 models 폴더로 내려받는다. |
requirements.txt | PyTorch, diffusers, transformers, peft, safetensors 등 실행 의존성을 정의한다. |
입력과 출력 예시
얼굴 익명화 입력 이미지 | 얼굴 익명화 45도 출력 |
|---|---|
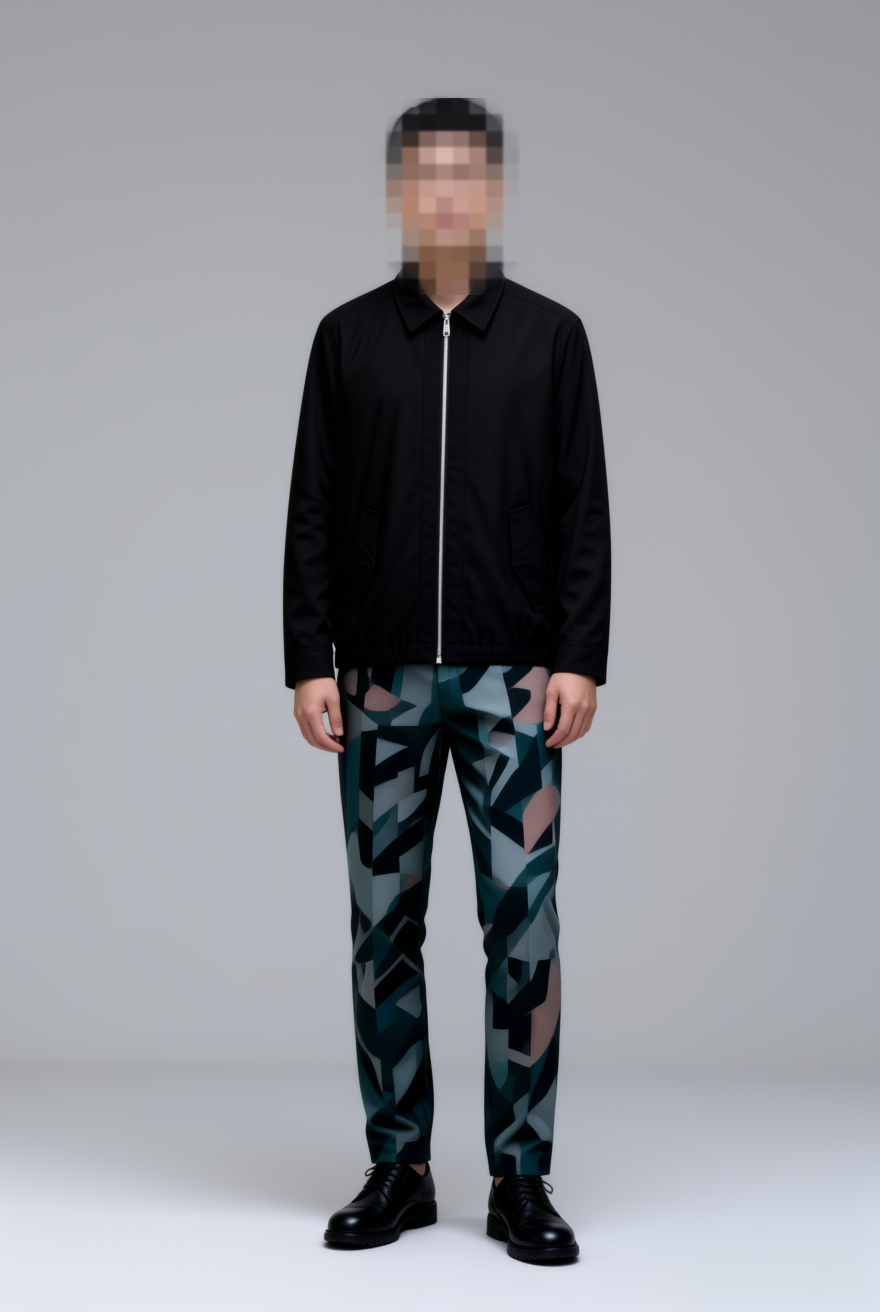 | 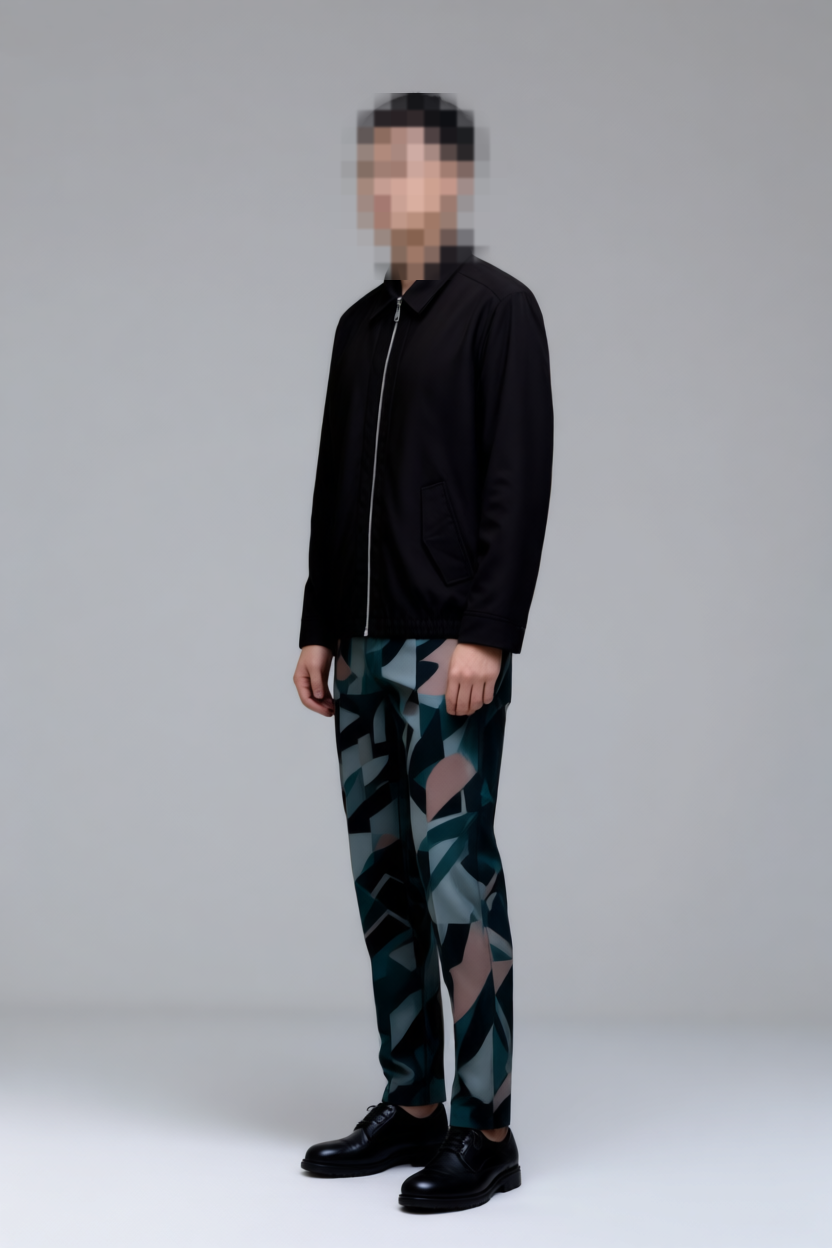 |
기존 모델의 한계
기존 가상 피팅 모델은 보통 정면 이미지에 강하고, 회전 각도는 제한된 경우가 많다. 예를 들어 45도 시점은 만들 수 있어도 모델의 얼굴이 흐려지거나, 옷의 패턴이 바뀌거나, 팔과 옷의 경계가 어색해지는 문제가 생긴다. 모델이 사람 자체를 충분히 기억하지 못하고, 매번 입력 이미지에서만 단서를 찾기 때문이다.
문제 | 왜 생기는가 | LoRA가 개선하는 부분 |
|---|---|---|
45도 이상 시점에서 정체성이 흐려짐 | 기본 모델은 특정 사람을 학습한 것이 아니라 일반 인물 분포를 학습했다. | 개인 이미지로 미세조정하면 얼굴, 체형, 분위기를 더 안정적으로 유지한다. |
옷 디테일이 바뀜 | 합성 과정에서 옷 이미지보다 생성 모델의 상상력이 앞설 수 있다. | 옷 이미지 조건과 프롬프트 규칙을 고정해 디자인 보존을 강화한다. |
포즈와 신체 경계가 어색함 | 사람과 옷의 가려짐 관계를 한 번에 해결해야 한다. | 여러 각도와 거리 예제를 학습해 시점별 형태 일관성을 높인다. |
매번 결과가 흔들림 | 시드와 프롬프트에 따라 생성 결과가 크게 달라질 수 있다. | 개인화 LoRA는 모델이 돌아갈 기준점을 제공한다. |
LoRA는 무엇을 바꾸는가
LoRA는 거대한 기본 모델 전체를 다시 학습하지 않고, 작은 가중치 묶음만 추가로 학습하는 방법이다. 이 프로젝트의 LoRA 파일은 약 281MB로, 수십 GB 규모의 기본 모델에 비해 작다. 그래서 사용자는 기본 모델의 일반적인 이미지 편집 능력은 유지하면서, 특정 작업에 필요한 습관만 덧입힐 수 있다.
가상 피팅에서는 LoRA가 두 가지 방향으로 쓰인다. 첫째, 여러 각도에서 사람을 안정적으로 돌려 보는 능력이다. 둘째, 특정 사람을 더 잘 알아보도록 만드는 개인화 능력이다. 처음에는 공개된 Multiple-Angles LoRA를 사용하고, 다음 단계에서는 사용자의 사진과 옷 착용 예시를 모아 개인 모델 LoRA로 발전시킨다.
프롬프트로 시점을 제어하기
이 프로젝트의 프롬프트는 '<sks> [azimuth] [elevation] [distance]' 형식이다. '<sks>'는 LoRA가 반응하는 트리거 토큰이고, 뒤의 세 요소는 카메라가 어느 방향과 높이, 거리에서 사람을 볼지 지정한다.
구분 | 예시 | 의미 |
|---|---|---|
azimuth | front view, front-right quarter view, right side view, back-right quarter view | 사람을 어느 수평 각도에서 볼지 정한다. |
elevation | low-angle shot, eye-level shot, elevated shot, high-angle shot | 카메라의 높낮이를 정한다. |
distance | close-up, medium shot, wide shot | 상반신 중심인지 전신 중심인지 정한다. |
<sks> front-left quarter view elevated shot medium shot
<sks> right side view eye-level shot wide shot
<sks> back view low-angle shot medium shot
가상 피팅으로 확장하기
현재 코드는 두 번째 입력 이미지도 받을 수 있다. 이 지점을 이용하면 첫 번째 이미지는 사람, 두 번째 이미지는 옷으로 두고 모델에게 '이 사람이 이 옷을 입은 모습'을 만들라고 지시할 수 있다. 즉, 단순 회전 모델에서 출발해 사람 조건과 의류 조건을 함께 읽는 가상 피팅 모델로 확장할 수 있다.
python infer.py \
  --image inputs/person.png \
  --image2 inputs/cloth.png \
  --prompt "<sks> front-right quarter view eye-level shot medium shot, the person is wearing the garment from the second image" \
--output outputs/tryon_front_right.png개인화 LoRA로 발전하는 과정
개인화 LoRA의 목표는 한 사람의 얼굴, 체형, 어깨선, 전체 인상을 모델이 더 잘 기억하게 만드는 것이다. 같은 옷을 입혀도 사람마다 옷이 걸리는 방식이 다르기 때문에, 가상 피팅의 품질은 사람을 얼마나 안정적으로 유지하느냐에 달려 있다.
- 1단계: 같은 사람의 정면, 45도, 측면, 후면 이미지를 모은다.
- 2단계: 옷 종류, 시점, 거리, 조명 정보를 캡션으로 붙인다.
- 3단계: 기본 모델은 고정하고 LoRA 가중치만 학습한다.
- 4단계: 학습된 LoRA를 추론 스크립트에 연결해 같은 프롬프트를 다시 실행한다.
- 5단계: 얼굴 유지, 체형 유지, 옷 디테일 보존, 배경 안정성을 비교한다.
학습 데이터 설계
가상 피팅 데이터는 단순히 사진을 많이 모은다고 좋아지지 않는다. 각 사진이 어떤 목적을 갖는지 명확해야 한다. 모델에게는 이미지와 함께 캡션이 주어지고, 캡션은 모델이 어떤 특징을 배워야 하는지 알려 주는 지도 역할을 한다.
데이터 | 필요한 이유 | 예시 캡션 |
|---|---|---|
사람 기본 이미지 | 얼굴과 체형을 기억하게 한다. | <person_lora> front view eye-level medium shot |
다중 각도 이미지 | 45도 제약을 넘고 측면과 후면을 안정화한다. | <person_lora> right side view eye-level medium shot |
의류 단독 이미지 | 옷의 색, 패턴, 길이, 소재감을 보존한다. | black wool coat, long length, visible buttons |
착용 예시 | 사람과 옷의 결합 방식을 학습한다. | <person_lora> wearing black wool coat, front-right quarter view |
추론 파이프라인
완성된 프로그램은 세 단계로 동작한다. 사용자가 사람 이미지를 넣고 옷 이미지를 넣으면, 시스템은 프롬프트를 만들고, 기본 이미지 편집 모델에 개인화 LoRA와 각도 LoRA를 적용해 결과를 생성한다. 마지막으로 사용자는 마음에 드는 각도와 거리를 선택해 쇼핑 화면이나 룩북에 사용할 수 있다.
person image + garment image
  -> prompt builder
  -> Qwen-Image-Edit-2511 base model
  -> Multiple-Angles LoRA + Personal LoRA
  -> virtual try-on image
  -> human review and selected output
평가 기준
평가 항목 | 질문 |
|---|---|
사람 보존 | 결과 이미지의 얼굴과 체형이 입력 사람과 같은가? |
옷 보존 | 색, 패턴, 카라, 소매, 길이가 원본 의류와 일치하는가? |
착용 자연스러움 | 어깨, 팔, 허리, 밑단의 경계가 자연스러운가? |
시점 일관성 | 0도, 45도, 90도, 135도 결과가 같은 사람과 같은 옷으로 이어지는가? |
실사용성 | 쇼핑몰, 스타일링 앱, 개인 룩북에 넣을 정도로 깨끗한가? |
구현할 때 주의할 점
- Hugging Face 토큰은 코드에 직접 적지 말고 환경변수로 관리한다.
- 사람 사진과 의류 사진은 개인정보와 저작권 문제가 있으므로 학습 동의를 명확히 한다.
- LoRA 강도는 0.8에서 1.0 사이를 먼저 시험하고, 얼굴이 흔들리거나 옷이 과하게 변하면 낮춘다.
- 결과 이미지는 한 장만 보지 말고 여러 시드와 여러 각도로 비교한다.
- 실제 판매용 피팅 이미지라면 생성 이미지임을 사용자에게 투명하게 알려야 한다.
마무리
이 장의 핵심은 가상 피팅을 단순 이미지 편집 기능으로 보지 않는 것이다. 처음에는 기존 모델이 제공하는 제한된 회전과 편집 능력을 사용하지만, 사람과 옷 데이터를 모아 LoRA로 학습하면 모델은 점점 더 특정 사용자에게 맞는 피팅 모델이 된다. 즉, AI는 '옷을 입혀 주는 도구'에서 '나를 기억하고 여러 스타일을 실험해 주는 개인 모델'로 발전한다.
연습 문제
- 입력 사람 이미지를 바꾸고 0도, 45도, 90도, 135도 결과를 생성해 비교해 보자.
- 같은 사람 이미지에 서로 다른 옷 이미지를 넣어 옷 보존이 잘 되는지 확인해 보자.
- LoRA scale을 0.6, 0.8, 1.0으로 바꾸고 얼굴 유지와 옷 변형 정도를 표로 정리해 보자.
- 개인화 LoRA 학습을 위한 최소 데이터셋 폴더 구조와 캡션 규칙을 설계해 보자.
댓글 0
아직 댓글이 없습니다.