문랜딩 프로그램으로 이해하는 강화학습
달 착륙선이 시행착오를 통해 안전한 착륙 방법을 배우는 과정
왜 문랜딩인가
문랜딩, 즉 달 착륙 문제는 강화학습을 설명하기에 아주 좋은 소재다. 목표는 단순하다. 착륙선을 목표 지점 근처에 천천히, 똑바로, 연료를 아끼며 내려놓으면 된다. 하지만 실제 조작은 단순하지 않다. 아래 엔진을 켜면 속도는 줄지만 연료가 줄고, 좌우 보조 분사기를 켜면 위치와 자세가 동시에 변한다. 한 번의 잘못된 조작은 나중에 큰 기울기나 빠른 낙하 속도로 돌아온다.
이 프로젝트는 그런 문제를 작은 2D 물리 시뮬레이션으로 만든다. 그리고 DQN 에이전트가 수많은 실패를 겪으며 어떤 상태에서 어떤 분사기를 켜야 하는지 학습하게 한다.
강화학습의 네 가지 구성요소
구성요소 | 문랜딩 프로젝트에서의 의미 |
|---|---|
환경 | MoonLanderEnv. 달 중력, 착륙선 물리, 연료, 충돌 판정을 담당한다. |
상태 | x, y, vx, vy, theta, omega, fuel을 정규화한 7차원 벡터다. |
행동 | 4개 분사기의 ON/OFF 조합. 총 16개의 이산 행동이다. |
보상 | 목표에 가까워지고 안정되면 좋아지고, 연료 사용과 추락은 나빠지는 점수다. |
이 네 가지가 모이면 강화학습 루프가 만들어진다. 에이전트는 현재 상태를 보고 행동을 고른다. 환경은 그 행동으로 물리를 한 스텝 진행한 뒤, 다음 상태와 보상을 돌려준다. 에이전트는 이 경험을 저장하고 나중에 다시 꺼내 학습한다.
환경: 작은 우주 만들기
lander_env.py는 달 착륙선의 세계를 정의한다. 월드는 가로 200m, 세로 200m이고, 중력은 달의 중력인 1.625m/s²로 설정되어 있다. 착륙선에는 하부 메인 엔진, 상부 RCS, 좌측 RCS, 우측 RCS가 있다. 좌우 분사기는 위치를 바꾸는 동시에 회전 토크도 만든다.
항목 | 값 |
|---|---|
월드 크기 | 200m x 200m |
시간 간격 | 1/30초 |
중력 | 1.625 m/s² |
상태 차원 | 7 |
행동 개수 | 16 |
최대 스텝 | 600 |
상태: 모델이 보는 숫자
DQN은 화면을 직접 보는 대신 7개의 숫자를 입력으로 받는다. 이 값들은 학습이 안정되도록 정규화되어 있다.
[x_norm, y_norm, vx_norm, vy_norm, theta_norm, omega_norm, fuel_norm]x와 y는 위치, vx와 vy는 속도, theta는 기울기, omega는 회전 속도, fuel은 남은 연료다. 이 7개 값만 있어도 착륙선이 어디에 있고, 얼마나 빠르게 움직이며, 얼마나 위험한 자세인지 판단할 수 있다.
행동: 16가지 분사기 조합
행동은 4개의 분사기 ON/OFF를 비트로 표현한다. 분사기가 4개이므로 가능한 조합은 2⁴, 즉 16개다.
bit 0: 하부 메인 엔진
bit 1: 상부 RCS
bit 2: 좌측 RCS
bit 3: 우측 RCS
예를 들어 행동 1은 bit 0만 켜진 상태이므로 메인 엔진만 분사한다. 행동 5는 0101이므로 메인 엔진과 좌측 RCS를 함께 켠다. 이산 행동으로 만들면 DQN이 각 행동의 가치를 비교하기 쉬워진다.
보상: 착륙을 향한 방향 신호
강화학습에서 가장 까다로운 부분은 보상 설계다. 이 프로젝트는 매 스텝마다 '좋은 상태에 가까워졌는가'를 shaping 차분으로 계산한다. 목표 지점과의 거리, 자세, 속도, 각속도를 종합해 상태의 품질을 평가하고, 이전 스텝보다 좋아졌으면 양의 보상을 준다.
reward += new_shaping - prev_shaping
reward -= 0.03 * active_thruster_count
착륙에 성공하면 큰 보상을 받고, 추락하거나 화면을 벗어나면 큰 페널티를 받는다. 안전 착륙 조건은 목표 영역 안에 있고, 속도가 낮고, 거의 수직이며, 회전이 안정된 상태다.
결과 | 보상/페널티 |
|---|---|
안전 착륙 | +200 기본 보상에 정밀도와 연료 보너스 추가 |
추락 | -100 |
화면 이탈 | -100 |
시간 초과 | -30 |
분사기 사용 | 켜진 분사기 수에 비례한 작은 페널티 |
DQN: 행동의 가치를 배우는 모델
dqn_agent.py는 Dueling Double DQN 구조를 사용한다. DQN은 상태 s에서 행동 a를 했을 때 앞으로 받을 보상의 합, 즉 Q(s,a)를 예측한다. 에이전트는 Q값이 가장 큰 행동을 고르면 되지만, 학습 초반에는 모르는 것이 많으므로 일부러 무작위 행동도 섞는다.
Q(s, a) = V(s) + A(s, a) - mean(A(s, *))Dueling 구조는 상태 자체의 가치 V(s)와 행동별 이점 A(s,a)를 나누어 학습한다. Double DQN은 다음 행동 선택은 현재 네트워크가 하고, 그 행동의 평가는 타깃 네트워크가 하게 해 과대평가를 줄인다.
경험 재생: 실패도 다시 써먹기
착륙선은 대부분 실패하면서 배운다. 중요한 점은 실패한 경험도 버리지 않는다는 것이다. ReplayBuffer는 상태, 행동, 보상, 다음 상태, 종료 여부를 저장한다.
(state, action, reward, next_state, done)학습할 때는 최근 한 에피소드만 보지 않고 버퍼에서 무작위 샘플을 뽑는다. 이렇게 하면 데이터의 순서 의존성이 줄고, 다양한 상황을 섞어 더 안정적으로 학습할 수 있다.
탐험과 활용
에이전트는 처음부터 좋은 착륙 방법을 모른다. 그래서 epsilon-greedy 전략을 사용한다. 처음에는 epsilon이 1.0이라 거의 무작위로 움직이고, 시간이 지나며 0.05까지 줄어든다.
epsilon: 1.0 -> 0.05 over 80,000 environment steps이 과정은 탐험과 활용의 균형이다. 탐험은 새로운 행동을 시도하는 것이고, 활용은 지금까지 배운 Q값을 믿고 가장 좋아 보이는 행동을 고르는 것이다.
학습 스크립트의 흐름
- 환경 생성: MoonLanderEnv를 만들고 초기 상태를 reset한다.
- 행동 선택: DQNAgent가 현재 상태에서 epsilon-greedy로 행동을 고른다.
- 환경 진행: env.step(action)으로 물리를 한 스텝 진행한다.
- 경험 저장: transition을 replay buffer에 넣는다.
- 학습: 버퍼가 충분히 차면 미니배치를 뽑아 Q 네트워크를 업데이트한다.
- 평가와 저장: 일정 에피소드마다 greedy 정책으로 평가하고 best.pt와 last.pt를 저장한다.
실행 방법
python train.py
python train.py --episodes 2000
python train.py --render

python play.py --episodes 5
python play.py --learn
python play.py --human
train.py는 정해진 에피소드 수만큼 학습하고 결과를 저장한다. play.py는 학습된 모델을 실행하거나, 화면을 보면서 계속 학습하거나, 사람이 직접 조작해 환경을 점검하는 데 사용한다.
학습 결과 읽기
현재 로그 기준으로 1500 에피소드 학습이 수행되었고, 마지막 환경 스텝 수는 364,786이다. 다만 평가 성공률은 아직 0.0으로 남아 있다. 이것은 실패가 아니라 강화학습 글에서 매우 중요한 관찰점이다. 환경을 만든다고 곧바로 좋은 정책이 나오는 것은 아니다. 보상, 탐험, 네트워크 크기, 초기 조건, 학습 시간 모두가 결과에 영향을 준다.
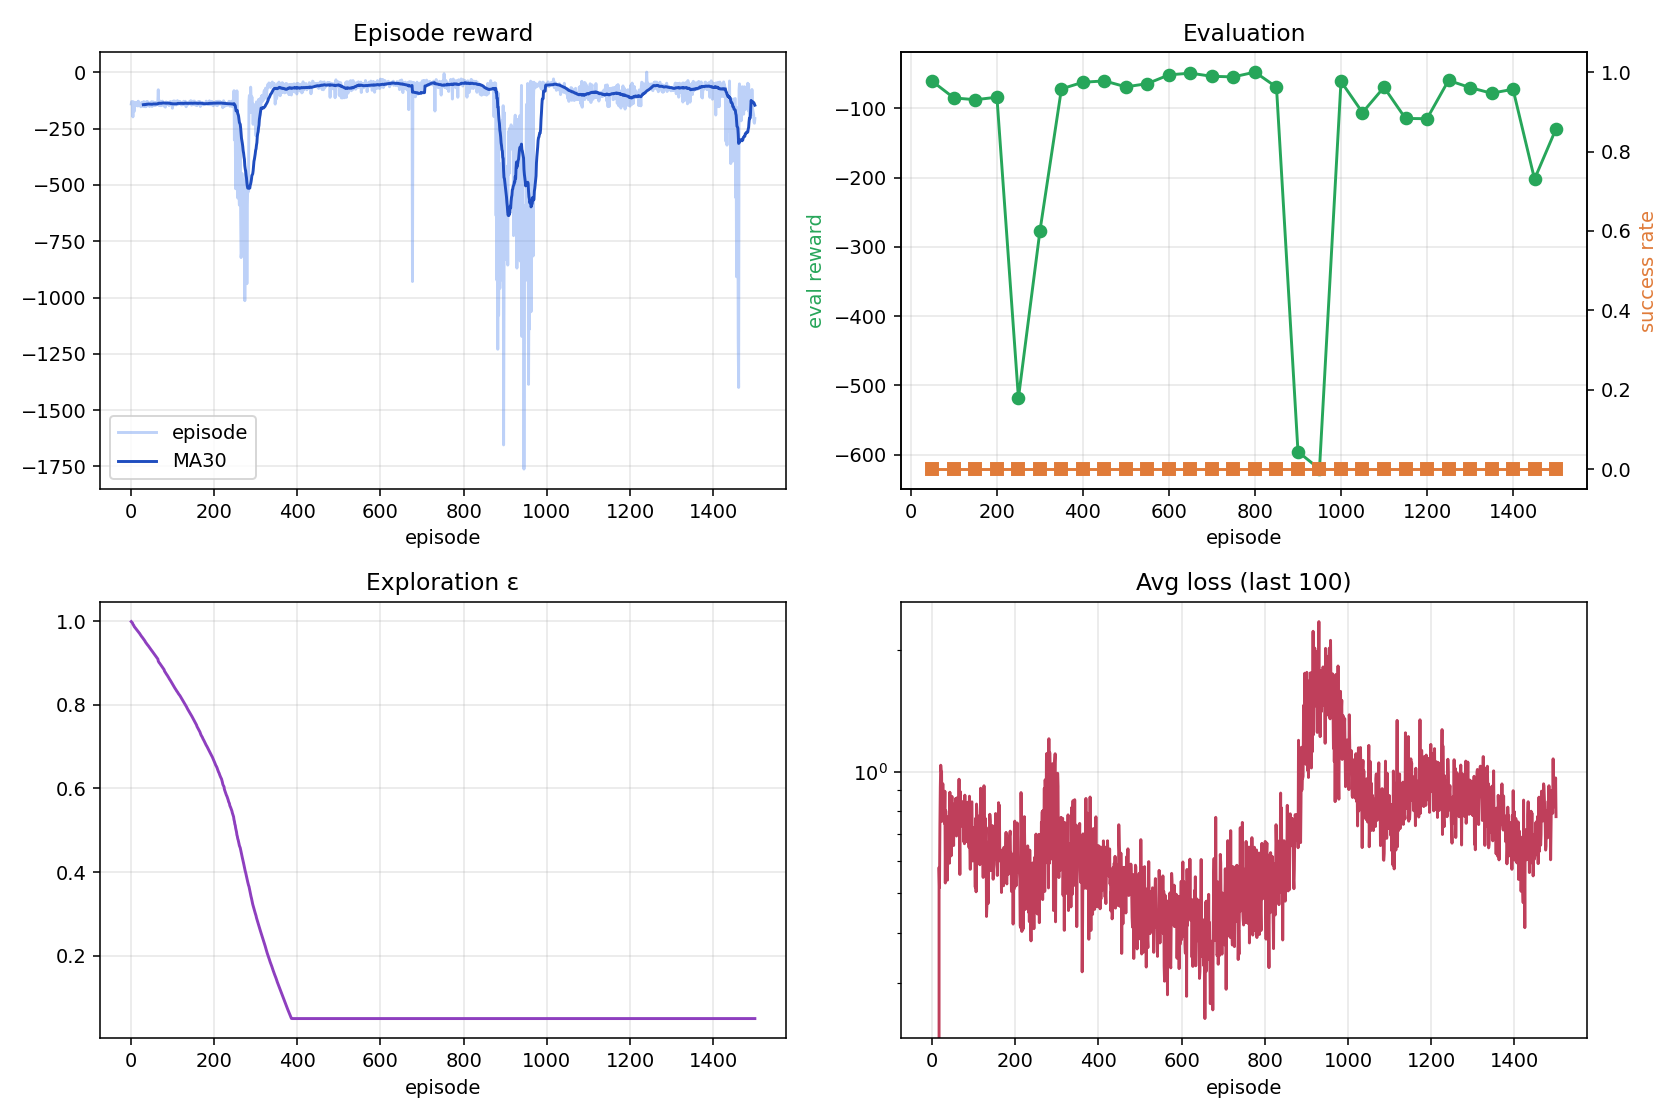
그림. 에피소드 보상, 평가 보상, epsilon, loss 변화
왜 아직 착륙하지 못할까
현재 결과가 완전한 성공으로 이어지지 않은 이유는 여러 가지일 수 있다. 이 부분은 책에서 독자에게 강화학습의 현실감을 전달하기 좋다.
- 착륙 성공 보상이 드물어 모델이 좋은 행동을 충분히 경험하지 못했을 수 있다.
- 16개 행동 조합 중 일부는 물리적으로 비효율적이어서 탐험 공간이 생각보다 클 수 있다.
- 보상 shaping이 목표 접근, 속도 감소, 자세 안정 중 어느 쪽을 더 강하게 밀어야 하는지 아직 조정이 필요할 수 있다.
- 학습 에피소드가 더 필요하거나, curriculum learning처럼 쉬운 시작 조건에서 점점 어렵게 만드는 방식이 필요할 수 있다.
- DQN보다 연속 제어에 강한 PPO, SAC 계열 접근이 더 잘 맞을 수도 있다.
개선 실험 아이디어
실험 | 기대 효과 |
|---|---|
고정 시작점으로 먼저 학습 | 초기 문제를 단순화해 착륙 성공 경험을 더 빨리 만든다. |
성공 조건 완화 후 점진 강화 | curriculum learning으로 희소 보상 문제를 줄인다. |
연료 페널티 약화 | 초반에는 생존과 자세 안정에 집중하게 한다. |
행동 공간 축소 | 상부 RCS처럼 자주 필요 없는 조합을 줄여 탐험을 쉽게 만든다. |
평가 리플레이 저장 | 실패 궤적을 보고 보상 설계의 문제를 찾는다. |
마무리
문랜딩 프로그램은 강화학습의 본질을 잘 보여 준다. 에이전트는 정답을 받지 않는다. 대신 행동하고, 실패하고, 조금 나은 방향을 보상으로 감지하고, 그 경험을 다시 학습한다. 착륙이라는 목표는 단순하지만, 그 목표에 도달하기 위해서는 상태 표현, 행동 설계, 보상 설계, 탐험 전략이 모두 맞물려야 한다.
따라서 이 장의 결론은 'DQN으로 달 착륙선을 완벽히 착륙시켰다'가 아니다. 더 좋은 결론은 '강화학습은 환경을 설계하고 실패를 해석하는 기술이다'이다. 문랜딩은 그 사실을 가장 눈에 잘 보이게 만들어 주는 작은 실험실이다.
연습 문제
- 상태 벡터에서 fuel을 제거하면 학습 결과가 어떻게 달라질지 예상해 보자.
- 분사기 사용 페널티를 0.03에서 0.0으로 바꾸면 어떤 행동이 늘어날까?
- 초기 위치를 고정한 상태로 학습한 모델이 랜덤 시작점에서도 잘 작동할지 생각해 보자.
- 안전 착륙 보상을 +200에서 +500으로 키우면 희소 보상 문제가 줄어들까, 아니면 학습이 불안정해질까?
댓글 0
아직 댓글이 없습니다.