OpenAI Gym과 강화학습(Reinforcement)
초창기 OpenAI Gym의 분위기
알다시피 OpenAI는 비영리 단체로 시작했다. 당시의 OpenAI는 지금의 거대한 생성형 AI 플랫폼과 조금 결이 달랐다. 그 당시에는 샘 알트만과 일론 머스크의 사이가 벌어지기 전이면 일론 머스크는 OpenAI의 큰 투자자였다. 2016년 4월 27일 공개된 OpenAI Gym은 '강화학습 알고리즘을 개발하고 비교하기 위한 도구'로 소개되었다. 비영리 목적의 개발자 환경에서 누구나 실행해 보고, 알고리즘을 직접 구현해 보고, 결과를 비교하며, 재현 가능한 연구 문화를 만들려는 순수한 연구 도구에 가까웠다.
이 당시 OpenAI에서는 자주 대회가 열렸고 그 내용이 YouTube로 그대로 중계가 되었다. 대회는 간단했다. OpenAI Gym에서 제공한 게임을 학습한 Agent가 가장 빨리 결승선을 통과하거나 문제를 해결하는 대회였다. 그 대회에서 우승한 사람들은 순식간에 명예를 얻었고 전 세계에 자신의 이름을 알릴 수가 있었다. 그 당시에는 OpenAI는 비영리 단체였으므로 비디오 게임에 들어가는 수 많은 Rom파일(보통 마메라고 불렀다)을 제공받아 강화학습용 라이브러리와 환경(environment)으로 제공하였다. 프로그램을 실행하면 자신들이 어린시절 하던 게임화면이 실행되었고 행동(Action)을 Gym API를 통해서 입력하면 상태(status)가 제공되고 이번의 행동이 위치적으로 발전하였는지 퇴보하였는지 판단하여 보상(reward)이 제공되었다. 이때 같이 제공되는 상태(status)를 프로그램이 판단하여 다음 행동을 결정하고 행동이 입력되면 다음 상태가 제공되어 지게 된다. 바로 이 때 강화학습이 이루어 지게 되는데 보통 DQN이나 sarsa등의 방법이 이용되었다. 이 학습 내용이 피팅 파일(.pt)로 저장되니 Gym이라는 단어는 안성맞춤의 단어인 것이다. Gym이 중요했던 이유는 환경을 표준화하고 환경과 통신할 수 있는 라이브러리를 제공함으로써 전 세계 수 많은 프로그래머들에게 인공지능을 학습할 수 있는 인터넷 가상 공간을 제공하고 또한 Gym의 행사에 참여한 수 많은 인공지능 개발자로 인해 자연스러운 인재 풀을 형성할 수 있게 했다. 그 당시 Gym은 개발자들로 하여금 자신들이 어린시절 하던 게임을 자신이 아닌 AI가 할 수 있게 끔 길을 이끌어 주었다.
강화학습은 보상 함수, 행동 공간, 종료 조건이 조금만 달라도 학습된 파일에 문제가 발생하게 된다. 강화학습을 위해서는 에이전트(Agent)의 설계가 중요한데 이 에이전트는 Gym에서 제공하는 것이 아니라 온전히 프로그래머가 설계하고 만들어야 하는 것이다. OpenAI Gym은 env.reset(), env.step(action), observation, reward, done이라는 간단한 형식으로 환경에 대한 내용을 제공하고 에이전트가 실시한 행동(Action)을 env.step(action)으로 입력하여 그 행동의 결과를 리턴되는 상태(status)로 받게 된다.
프로그래머는 짐(Gym)으로 인해 프로그래머가 알기도 어렵고 쉽게 접근하기도 힘든 환경(environment)과 상태(status)라는 부분을 개발자가 개발해야 하는 부분에서 분리하고 오직 기능적인 에이전트(Agent) 개발에만 좀 더 집중하여 개발할 수 있게 함으로써 수 많은 프로그래머들이 새로운 아이디어를 반영한 훌륭한 인공지능을 만들 수 있게 해 주었다. 잠깐이 였지만 이러한 OpenAI의 기여로 인해서 지금의 인공지능 황금기를 맞게 되었다고 해도 과언이 아닐 것이다.
왜 강화학습이 중요한가
LLM을 학습시키는 것은 어떻게 진행되었을까? 초기의 LLM은 인터넷 데이터를 이용하여 학습했다. 현재도 인터넷에는 수많은 데이터가 있다. 하지만 그 만큼 쓰레기 데이터도 풍부하다 아니 95%의 쓰레기 데이터와 5%의 쓸모 있는 데이터로 구성된 것이 인터넷 세상이라고 해도 틀린 말이 아닐 것이다.
인공지능을 개발하는 많은 학자들은 지금의 LLM을 정답지를 외운 학생에 비유하곤 한다. 정답지를 달달 외우고 시험을 봐서 좋은 성적이 나왔다고 해서 그 학생의 지능이 우수하다고는 할 수 없을 것이다. 실제로 LLM은 자신이 잘 아는 문제에 대해서는 정답을 말하지만 자신이 모르는 문제를 만나면 환각을 일으킨다. LLM에게 새로운 학습방법 아니면 LLM의 차세대가 필요할 수 있다는 말이다.
그렇다면 지금은 어떤 방식으로 LLM을 학습하고 있을까? LLM에게 더 이상 인터넷의 위키를 학습시키고 있지는 않을 것 이다.
강화학습은 정답 라벨을 맞히는 학습이 아니다. 행동의 결과를 보고 더 나은 행동을 찾는 학습이다. 에이전트는 환경을 관찰하고, 행동을 선택하고, 보상을 받는다. 이 과정이 반복되면 에이전트는 당장의 보상만이 아니라 미래의 누적 보상을 고려하게 된다.
학습 방식 | 질문 | 예시 |
|---|---|---|
지도학습 | 이 입력의 정답은 무엇인가? | 이미지 분류, 문장 감정 분석 |
비지도학습 | 데이터 안의 구조는 무엇인가? | 군집화, 임베딩 |
강화학습 | 지금 어떤 행동을 해야 나중에 보상이 커지는가? | 게임, 로봇 제어, 자동 운전, 자원 배분 |
이 차이가 중요하다. 실제 세계의 많은 문제는 한 번의 예측으로 끝나지 않는다. 로봇은 계속 움직여야 하고, 게임 캐릭터는 계속 피하고 공격해야 하며, 주식이나 암호화폐 전략은 현재 행동이 미래 위험을 바꾼다. 강화학습은 바로 이런 연속 의사결정 문제를 다룬다.
Gym의 공통 인터페이스(API)와 프로그램 구조
간단한 예제로 Gym에 대하여 알아 보도록 하자. 이 책은 독자가 python 코드를 보면 어느 정도 이해를 한다는 전제에서 집필되었음을 참고하자. 아래 코드는 python 3.12와 OpenAI Gym API를 바탕으로 작성된 예제이다. 이제 더 이상 OpenAI의 Gym이 존재하지 않을 수 있다. 앞으로는 우리가 아래의 Gym 클래스를 만들어야 할 수도 있다는 점을 기억하자. Gym의 어느(클라우드의) 레포지토리에 “CartPole-v1”(꼭 v1이 아닐 수도 있다. V2 또는 v3일 수 있다. 수시로 버전이 바뀐다.)이라는 환경이 존재한다. 그 환경으로 gym을 만든다. 그럼 환경이 리턴된다.
처음 **환경이라는 말을 들으면 환경이라는 것이 생각하기에 따라 굉장히 어려울 수 있다. 생각에 이해를 돕자면 환경은 게임화면과 게임내에서의 중력, 그리고 인공지능이 할 수 있는 행동의 개수(앞으로 갈가?, 뒤로 갈가?) 같은 것 들이며 어떤 행동 즉 앞으로 가는 행위를 했을 때 그로 인해 바뀐 화면과 게임 캐릭터의 상태(죽기 일보 직전이거나 평온한 상태이거나)등을 말한다. 위의 예제는 순수한 Gym의 예제이다. 이 예제 프로그램의 맹점은 프로그래머가 그 상태를 알 수가 없다는 것이다.
개념 | 의미 |
|---|---|
environment | 문제가 일어나는 세계다. CartPole, MountainCar, LunarLander, Pong 등이 여기에 해당한다. |
observation/state | 에이전트가 현재 볼 수 있는 상태다. |
action | 에이전트가 선택할 수 있는 행동이다. |
reward | 방금 행동의 결과로 받은 점수다. |
terminated/truncated | 성공, 실패, 시간 제한 등으로 에피소드가 끝났는지 나타낸다. |
policy | 상태를 보고 행동을 고르는 규칙 또는 신경망이다. |
챕터의 예제 구성
파일 | 환경 | 모델/방식 | 설명 |
|---|---|---|---|
cartpol.py | CartPole-v1 | 렌더링 확인 + DQN 골격 | 환경 화면을 확인하고 간단한 DQN 모델 구조를 보여 준다. |
cartpol-dqn.py | CartPole-v1 | TensorFlow DQN | 카트를 좌우로 움직여 막대를 오래 세우는 문제다. |
moutainCar-dqn.py | MountainCar-v0 | TensorFlow DQN | 작은 자동차가 언덕을 오르도록 에너지를 모으는 문제다. |
LunarLander-dqn.py | LunarLander-v3 | TensorFlow DQN | 착륙선을 안전하게 착륙시키는 연속 의사결정 문제다. |
LunarLander-hgf.py | LunarLander-v3 | Stable-Baselines3 PPO | 직접 DQN을 구현하지 않고 검증된 PPO 구현을 사용한다. |
Pong-dqn.py | Pong-v0 | Atari + DQN 골격 | 고전 Atari 게임을 Gym 환경으로 불러오는 예제다. |
Breakout-dqn.py | Breakout-v4 | Atari + DQN 골격 | 벽돌깨기 환경을 같은 DQN 구조로 시도한다. |
DQN의 기본 구조
이 폴더의 핵심 구현은 DQN이다. DQN은 상태를 입력받아 각 행동의 Q값을 출력한다. Q값은 '이 상태에서 이 행동을 했을 때 앞으로 받을 누적 보상이 얼마나 클 것인가'를 뜻한다. 모델은 Dense 24, Dense 24, 출력층 구조로 단순하지만, 강화학습의 기본 부품을 모두 갖고 있다.
구성요소 | 프로젝트 코드 | 역할 |
|---|---|---|
Q 네트워크 | DQN(tf.keras.Model) | 상태를 보고 행동별 Q값을 예측한다. |
타깃 네트워크 | target_model | 학습 목표가 너무 빨리 흔들리지 않도록 복사본을 둔다. |
리플레이 메모리 | deque(maxlen=2000) | 경험을 저장하고 무작위 미니배치로 다시 학습한다. |
탐험 | epsilon-greedy | 처음에는 무작위 행동을 많이 하고 점점 모델을 믿는다. |
할인율 | discount_factor=0.99 | 미래 보상을 현재 가치로 가져온다. |
손실 | MSE(target - predict) | 예상 Q값과 목표 Q값의 차이를 줄인다. |
target = reward + (1 - done) * gamma * max_a Q_target(next_state, a)
loss = mean_square(target - Q_model(state, action))
CartPole: 가장 좋은 첫 예제
CartPole은 강화학습의 hello world에 가깝다. 카트 위에 막대가 세워져 있고, 에이전트는 왼쪽 또는 오른쪽으로 힘을 가한다. 목표는 막대가 넘어지지 않게 오래 버티는 것이다. 상태는 카트 위치, 속도, 막대 각도, 각속도이고 행동은 2개다.
cartpol-dqn.py는 DQNAgent를 만들고 300 에피소드 동안 학습한다. 매 스텝마다 상태를 받고, epsilon-greedy로 행동을 고르고, 경험을 memory에 넣고, 메모리가 충분해지면 train_model을 호출한다. 에피소드가 끝나면 target_model을 업데이트하고 평균 점수를 그래프로 저장한다.
MountainCar: 당장 보상보다 전략
MountainCar는 차가 언덕을 바로 오를 힘이 부족한 문제다. 좋은 행동은 무조건 오른쪽으로 가는 것이 아니라, 먼저 왼쪽으로 내려가 운동 에너지를 모은 뒤 오른쪽으로 올라가는 것이다. 이 예제는 강화학습이 왜 미래 보상을 봐야 하는지 보여 준다.
moutainCar-dqn.py는 CartPole과 거의 같은 DQN 틀을 사용한다. 환경만 MountainCar-v0로 바뀐다. 이것이 Gym의 힘이다. 환경이 바뀌어도 reset, step, action_space, observation_space라는 인터페이스가 같기 때문에 에이전트 구조를 재사용할 수 있다.
LunarLander: 보상 설계의 어려움
LunarLander는 착륙선을 안전하게 착륙시키는 문제다. 상태 차원과 행동 수가 늘고, 보상도 더 복잡하다. 프로젝트의 DQN 예제는 기본 보상에 추가 페널티를 넣어 목표에서 멀어지거나 불필요한 움직임을 하는 행동을 벌한다. 이 지점에서 독자는 보상 설계가 곧 문제 정의라는 사실을 배운다.
LunarLander-hgf.py는 Stable-Baselines3의 PPO를 사용한다. 직접 DQN을 구현하는 예제와 달리, PPO는 이미 검증된 라이브러리 구현을 가져와 학습한다. 책에서는 이 둘을 비교하면 좋다. 하나는 알고리즘의 내부를 배우기 좋고, 다른 하나는 실제 실험을 안정적으로 돌리기 좋다.
Atari: 화면 기반 강화학습으로 가는 문
Pong과 Breakout은 Atari 환경을 사용한다. 프로젝트는 ale_py를 등록한 뒤 Pong-v0, Breakout-v4를 만든다. 다만 현재 코드의 DQN 구조는 저차원 상태를 Dense 층에 넣는 형태라서, 실제 Atari 픽셀 학습에는 CNN 전처리와 프레임 스택이 필요하다. 이 점을 책에 솔직히 적는 것이 좋다.
환경 유형 | 관찰 | 권장 모델 |
|---|---|---|
CartPole/MountainCar/LunarLander | 작은 숫자 벡터 | MLP 기반 DQN 또는 PPO |
Pong/Breakout | 게임 화면 이미지 | CNN DQN, 프레임 스택, 회색조/리사이즈 전처리 |
학습 그래프 예시
프로젝트에는 일부 학습 결과 그래프가 PNG로 저장되어 있다. 그래프는 에피소드가 늘어나며 평균 점수가 어떻게 변하는지 보여 준다. 강화학습은 한 번에 정답을 맞히는 학습이 아니라, 시행착오의 흔적이 곡선으로 남는 학습이다.
cartpole_graph 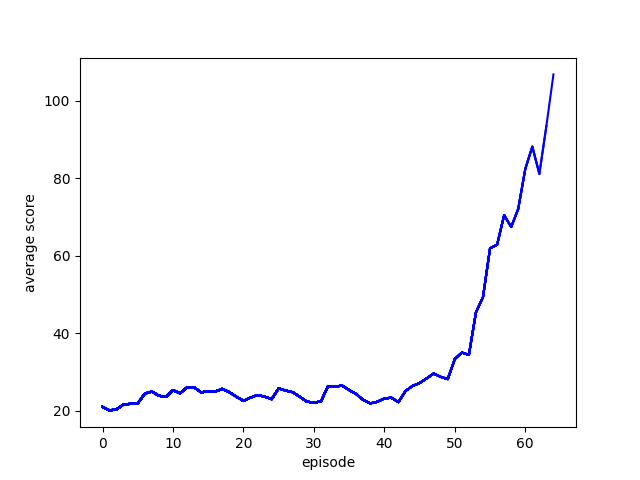 | MountainCar_graph 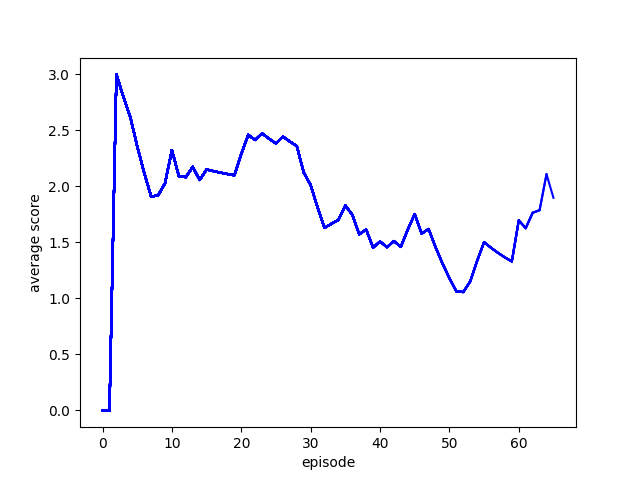 |
|---|---|
LunarLander_graph 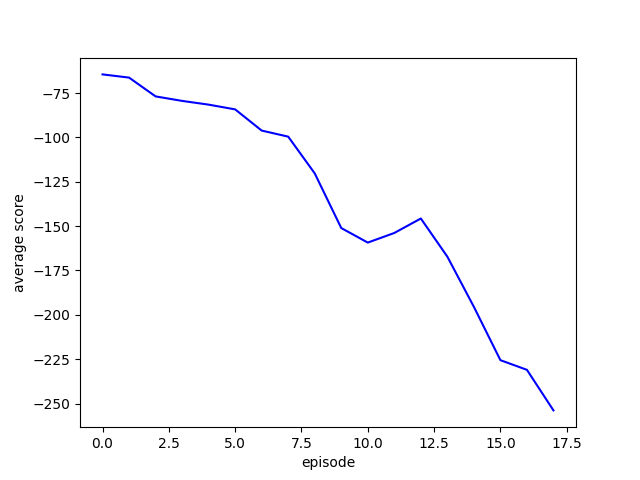 | Pong_graph 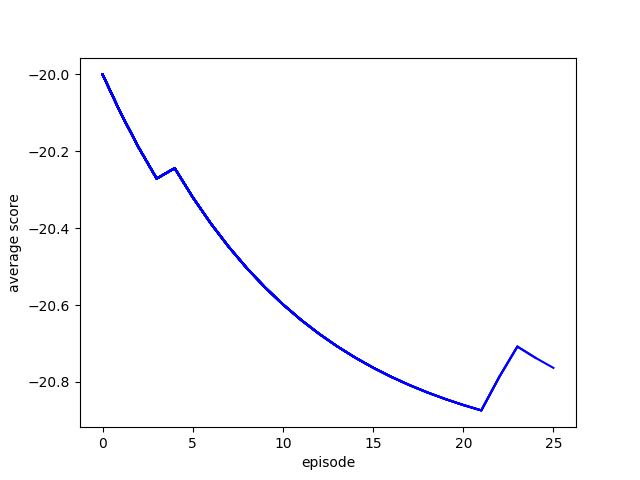 |
모델을 만드는 반복 과정
- 1단계: gym.make로 환경을 만든다.
- 2단계: observation_space와 action_space로 입력 차원과 행동 수를 확인한다.
- 3단계: 상태를 입력받아 행동별 Q값이나 확률을 내는 모델을 만든다.
- 4단계: epsilon-greedy 또는 정책 샘플링으로 탐험을 허용한다.
- 5단계: state, action, reward, next_state, done을 경험으로 저장한다.
- 6단계: 미니배치를 뽑아 DQN 또는 PPO 방식으로 모델을 업데이트한다.
- 7단계: 에피소드 점수, 평균 점수, 성공률을 기록한다.
- 8단계: 그래프와 저장 모델을 보고 학습이 실제로 나아졌는지 검증한다.
코드에서 고치면 좋은 점
지점 | 개선 방향 |
|---|---|
done 처리 | Gymnasium API에서는 terminated와 truncated를 함께 보고 done을 만든다. |
Atari 입력 | 이미지 관찰을 그대로 Dense에 넣기보다 CNN 전처리로 바꾼다. |
모델 저장 | TensorFlow 저장 형식을 파일별로 일관되게 정리한다. |
평가 분리 | 학습 중 점수와 학습 후 deterministic 평가를 분리한다. |
시드 고정 | env.reset(seed=...), numpy, random, TensorFlow seed를 맞춰 재현성을 높인다. |
보상 수정 | 환경 기본 보상과 사용자가 추가한 보상을 명확히 구분해 기록한다. |
Gym이 남긴 유산
Gym의 가장 큰 유산은 복잡한 강화학습 문제를 같은 형식으로 다룰 수 있게 만든 것이다. 오늘날 Gymnasium, Stable-Baselines3, RLlib, PettingZoo 같은 도구들도 이 인터페이스의 영향을 강하게 받는다. 환경과 에이전트를 분리하고, 같은 알고리즘을 여러 환경에 적용하는 습관은 지금도 강화학습 연구와 실습의 기본이다.
연습 문제
- CartPole에서 epsilon_decay를 0.999와 0.995로 바꾸고 평균 점수 그래프를 비교해 보자.
- MountainCar에서 reward shaping을 추가하지 않았을 때와 추가했을 때 학습 속도를 비교해 보자.
- LunarLander DQN과 PPO의 평균 점수, 학습 시간, 안정성을 표로 정리해 보자.
- Pong과 Breakout 예제를 CNN 기반 DQN 구조로 바꾸기 위한 전처리 단계를 설계해 보자.
- Gymnasium 환경 하나를 새로 골라 이 폴더의 DQNAgent 구조에 연결해 보자.
참고 자료
- OpenAI, OpenAI Gym Beta, 2016-04-27: https://openai.com/index/openai-gym-beta/
- openai/gym GitHub repository: https://github.com/openai/gym
- OpenAI Gym whitepaper: https://arxiv.org/abs/1606.01540
- Gymnasium documentation: https://gymnasium.farama.org/
- Stable-Baselines3 documentation: https://stable-baselines3.readthedocs.io/
댓글 0
아직 댓글이 없습니다.